Mitarbeitende suchen jeden Tag nach Antworten, die längst irgendwo im Unternehmen aufgeschrieben sind: in Richtlinien, Handbüchern und Protokollen. Ein Unternehmens-GPT beantwortet solche Fragen aus den eigenen Dokumenten, nennt die Quelle und läuft auf Sprachmodellen in der EU. Dieser Beitrag aus der Reihe „Projekte im Detail“ beschreibt Aufbau und Architektur eines solchen Systems und eine Methode, mit der sich sein Nutzen rechnen lässt.
Ausgangslage
In vielen Unternehmen liegt das Wissen verstreut: in Intranet-Seiten, Dateiablagen und PDF-Handbüchern. Wer eine Frage hat, sucht lange oder ruft jemanden an, der es wissen könnte. So binden einfache Fragen genau die Fachleute, die für anderes gebraucht werden.
Gibt es kein freigegebenes Werkzeug, besteht das Risiko, dass Mitarbeitende private KI-Konten für berufliche Texte nutzen. Das nennt man Schatten-KI. Firmeninhalte landen dann bei Anbietern ohne Vertrag mit dem Unternehmen, und niemand weiß, welche Daten wohin gehen. Ein Verbot allein löst das nicht: Es braucht eine bessere Alternative.
Ziel
Ein Unternehmens-GPT löst beide Probleme zugleich. Es ersetzt private Chat-Konten durch ein sicheres Werkzeug und öffnet einen direkten Zugang zum eigenen Wissen. Daraus ergeben sich fünf Anforderungen:
- Ein Chat für alle Mitarbeitenden, angemeldet mit dem bestehenden Firmenkonto über Single Sign-on (SSO).
- Antworten aus internen Dokumenten mit Verweis auf die Quelle, damit jede Aussage prüfbar bleibt.
- Austauschbare Sprachmodelle, ohne die Oberfläche neu zu bauen.
- Kosten, die sichtbar sind und sich begrenzen lassen.
- Verarbeitung der Daten in der EU.
Ein eigenes Modell zu trainieren, gehört fast nie dazu. Für Fragen an Dokumente reicht ein gutes Basismodell mit Retrieval Augmented Generation (RAG): Das Modell liest zu jeder Frage die passenden Textstellen nach, statt sie auswendig zu lernen.
Architektur
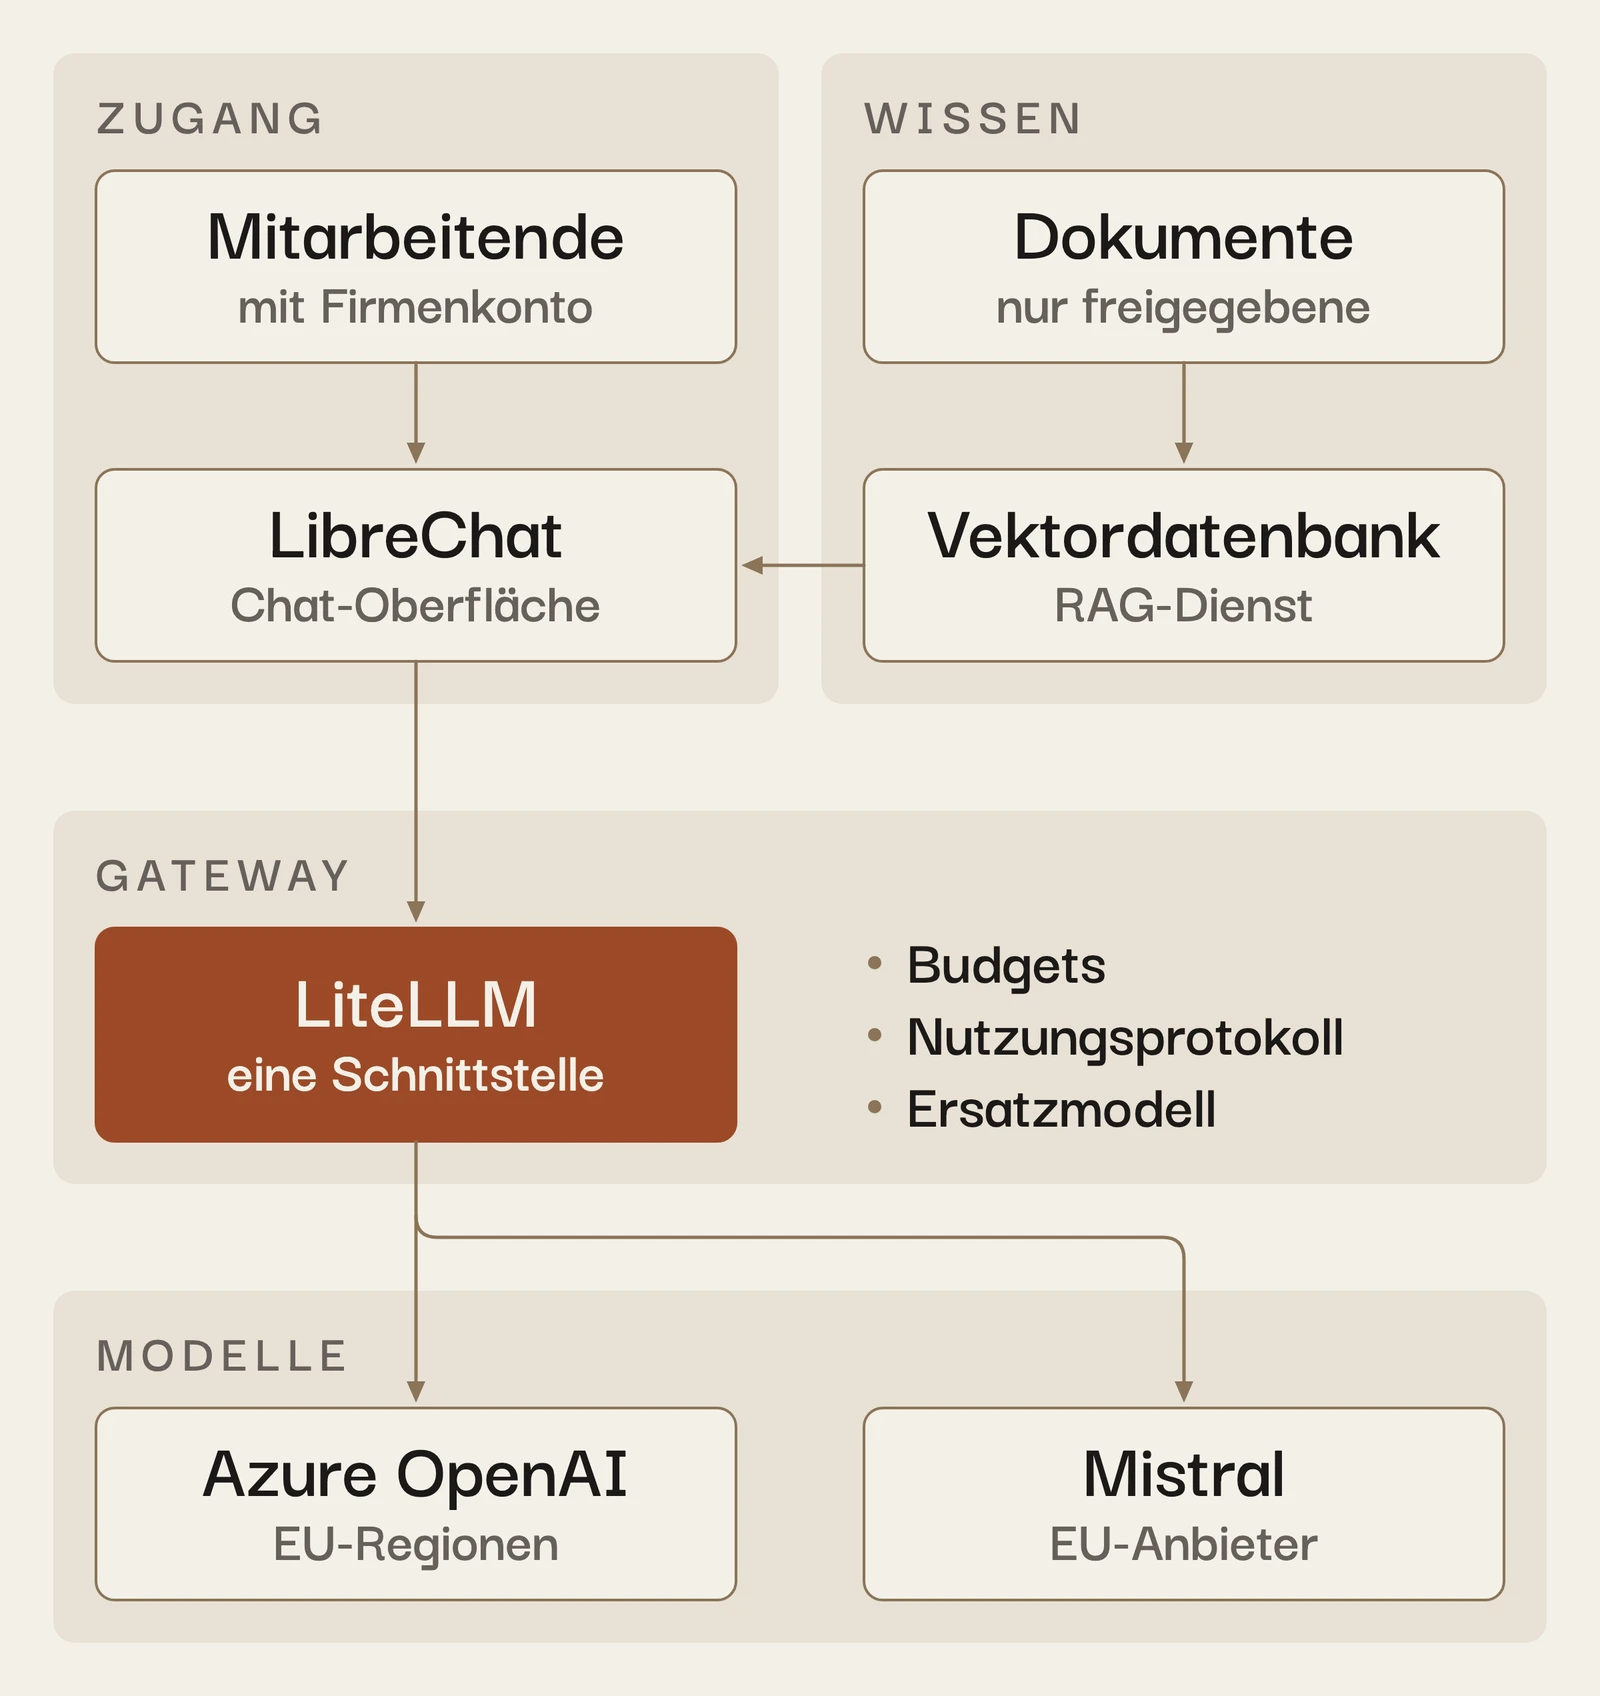
Das System besteht aus vier Schichten: Oberfläche, Wissen, Gateway und Modelle. Jede lässt sich einzeln austauschen.
- LibreChat (librechat.ai): die quelloffene Chat-Oberfläche. Sie übernimmt Anmeldung, Gesprächsverlauf, Datei-Upload und die Wahl des Modells.
- Single Sign-on: Anmeldung über den bestehenden Identitätsanbieter des Unternehmens. Wer das Unternehmen verlässt, verliert mit dem Firmenkonto auch den Zugang zum Chat.
- RAG-Dienst mit Vektordatenbank: zerlegt freigegebene Dokumente in Abschnitte, speichert sie als Vektoren und liefert zu jeder Frage die passenden Stellen.
- LiteLLM (docs.litellm.ai) als Modell-Gateway: eine einheitliche Schnittstelle zu allen Modellen, mit Routing, Budgets und Protokollierung.
- Sprachmodelle in der EU: zum Beispiel Azure OpenAI in EU-Regionen und Modelle von Mistral.
- Auswertung: Nutzung und Kosten, direkt aus den Daten des Gateways.
Umsetzung
Die Umsetzung beginnt mit einem kleinen Pilotkreis aus mehreren Abteilungen und mit echten Fragen aus deren Alltag. Die meiste Arbeit steckt in den Dokumenten, nicht im Chat. Veraltete Fassungen, doppelte Handbücher und eingescannte PDFs ohne Textebene liefern schlechte Antworten. Vor dem Import steht deshalb eine Bereinigung: eine gültige Fassung je Dokument, eine verantwortliche Person und ein Datum für die nächste Prüfung.
Die zweite Grundregel betrifft Berechtigungen. Der Chat darf nur wissen, was die fragende Person auch selbst lesen darf. Sinnvoll ist ein Start mit Dokumenten, die ohnehin für alle Mitarbeitenden freigegeben sind. Bereiche mit engerem Zugriff kommen später als eigene Wissenssammlungen dazu, die nur bestimmte Gruppen sehen.
Im Gateway lassen sich virtuelle Schlüssel vergeben, zum Beispiel je Abteilung oder je Anwendung, jeweils mit eigenem Budget. Fällt ein Modell aus oder ist es überlastet, leitet LiteLLM auf ein Ersatzmodell um. Für LibreChat sieht das Ganze wie ein einziger OpenAI-kompatibler Endpunkt aus. Ein neues Modell einzubinden, heißt deshalb: ein Eintrag im Gateway, kein Umbau der Oberfläche.
Jede Antwort nennt die Dokumente, aus denen sie stammt. Das schafft Vertrauen und macht Fehler sichtbar.
Ein Werkzeug ohne Einführung bleibt leer. Kurze Schulungen, eine Seite mit Beispielfragen und Ansprechpersonen in den Abteilungen gehören deshalb zum Projekt. Artikel 4 des AI Act verpflichtet Unternehmen seit Februar 2025 ohnehin, die KI-Kompetenz ihrer Mitarbeitenden zu fördern.
Infrastruktur und EU-Konformität
Bei Azure OpenAI entscheidet der Bereitstellungstyp, wo Anfragen verarbeitet werden. Bereitstellungen vom Typ „Global“ dürfen Anfragen in jeder Region verarbeiten, in der das Modell verfügbar ist, und scheiden deshalb aus. Bei Bereitstellungen vom Typ „Data Zone“ in einer EU-Region bleibt die Verarbeitung laut Microsoft-Dokumentation innerhalb der EU-Mitgliedstaaten. Mistral ist ein europäischer Anbieter mit Sitz in Paris und eignet sich als zweite Modellfamilie im Gateway.
LibreChat, Vektordatenbank und LiteLLM laufen am besten in einer eigenen Umgebung in einer EU-Region, beim Cloud-Anbieter des Unternehmens oder bei einem europäischen Hoster. Das Gateway protokolliert, wer welches Modell wie stark nutzt. Für die Kostenauswertung reichen diese Metadaten; LiteLLM lässt sich so einstellen, dass es Gesprächsinhalte nicht mitschreibt.
Vor dem Start sind zwei Punkte zu klären. Erstens die Einstufung nach dem AI Act: Ein interner Chat für Wissensfragen ist kein Hochrisiko-System. Das bleibt nur so, solange er nicht über Personal entscheidet; solche Einsätze nennt Anhang III ausdrücklich als hohes Risiko. Die Nutzungsrichtlinie schließt sie deshalb aus. Zweitens die Mitbestimmung: Ein Chat-System verarbeitet Daten von Mitarbeitenden. In Österreich braucht ein Betrieb mit Betriebsrat dafür in der Regel dessen Zustimmung nach §§ 96 und 96a ArbVG, meist in Form einer Betriebsvereinbarung. Wer den Betriebsrat früh einbindet, vermeidet einen Stopp kurz vor dem Start.
Ergebnis und Wertrechnung
Das Ergebnis ist ein Chat, den Mitarbeitende mit ihrem Firmenkonto öffnen und der Fragen aus freigegebenen Dokumenten mit Quellenangabe beantwortet. Modelle lassen sich im Gateway tauschen, ohne dass sich für die Nutzerinnen und Nutzer etwas ändert. Private KI-Konten für berufliche Texte verlieren ihren Grund.
Der Wert lässt sich mit einer festen Methode und ohne Pauschalannahmen rechnen:
- Zeitgewinn = beantwortete Fragen pro Woche × eingesparte Suchminuten je Frage × interner Stundensatz.
- Entlastung der Fachabteilungen = Rückfragen, die nicht mehr per Telefon oder Mail kommen, × Bearbeitungszeit je Rückfrage × interner Stundensatz.
- Kosten = Modellnutzung laut Gateway-Protokoll + Betrieb der Plattform + Pflege der Dokumente.
- Nettowert = Zeitgewinn + Entlastung − Kosten.
Die Suchminuten sollte man messen, nicht schätzen. Vor dem Start beantwortet eine Testgruppe eine Stichprobe echter Fragen auf dem alten Weg und stoppt die Zeit, danach dieselben Fragen mit dem Chat. Ein Wert lässt sich nicht in Geld fassen und zählt trotzdem: Firmenwissen fließt nicht mehr über private Konten ab.
Weitere Projekte finden Sie in der Übersicht der Referenzprojekte.