Wer Kundenmails, Verträge oder Personalakten mit einem Cloud-Sprachmodell bearbeiten will, steckt in einem Dilemma: Die stärksten Modelle laufen in der Cloud, die Daten dürfen dort nicht hin. Der AUSTR.AI PrivacyProxy löst das auf dem eigenen Rechner. Er erkennt personenbezogene Daten lokal und ersetzt sie durch Platzhalter, bevor ein Text das Gerät verlässt. Der PrivacyProxy ist eine Entwicklung von Florian Bieche unter der Marke AUSTR.AI; dieser Beitrag beschreibt, wie er aufgebaut ist.
Ausgangslage
Wer einen Text mit personenbezogenen Daten in ein Cloud-Sprachmodell eingibt, übermittelt diese Daten an den Anbieter: Namen, Adressen, Vertragsnummern. Von Hand zu schwärzen kostet Zeit und ist fehleranfällig. Anonymisierungsdienste in der Cloud verschieben das Problem nur: Die Daten verlassen trotzdem das Haus, nur zu einem anderen Anbieter.
Dazu kommt die Sprache. Viele Erkennungswerkzeuge sind vor allem auf englische Texte ausgelegt. Österreichische Adressen, akademische Titel wie „Mag.“ oder „DI“ und Namen von Behörden brauchen deshalb eigene Erkenner. Ein übersehener Name ist genau der Fehler, der zählt.
Ziel
- Erkennung und Anonymisierung laufen vollständig lokal, ohne Umweg über einen fremden Server, auch nicht über einen Server von AUSTR.AI.
- Freie Wahl des Modells: Cloud-Anbieter mit eigenem Schlüssel oder lokale Modelle.
- Die Antwort kommt mit den echten Namen zurück und liest sich wie ohne Proxy.
- Im Zweifel blockiert der Proxy, statt durchzulassen.
- Die Kontrolle bleibt beim Menschen: Nichts geht ohne Klick auf „Senden“ hinaus.
Architektur
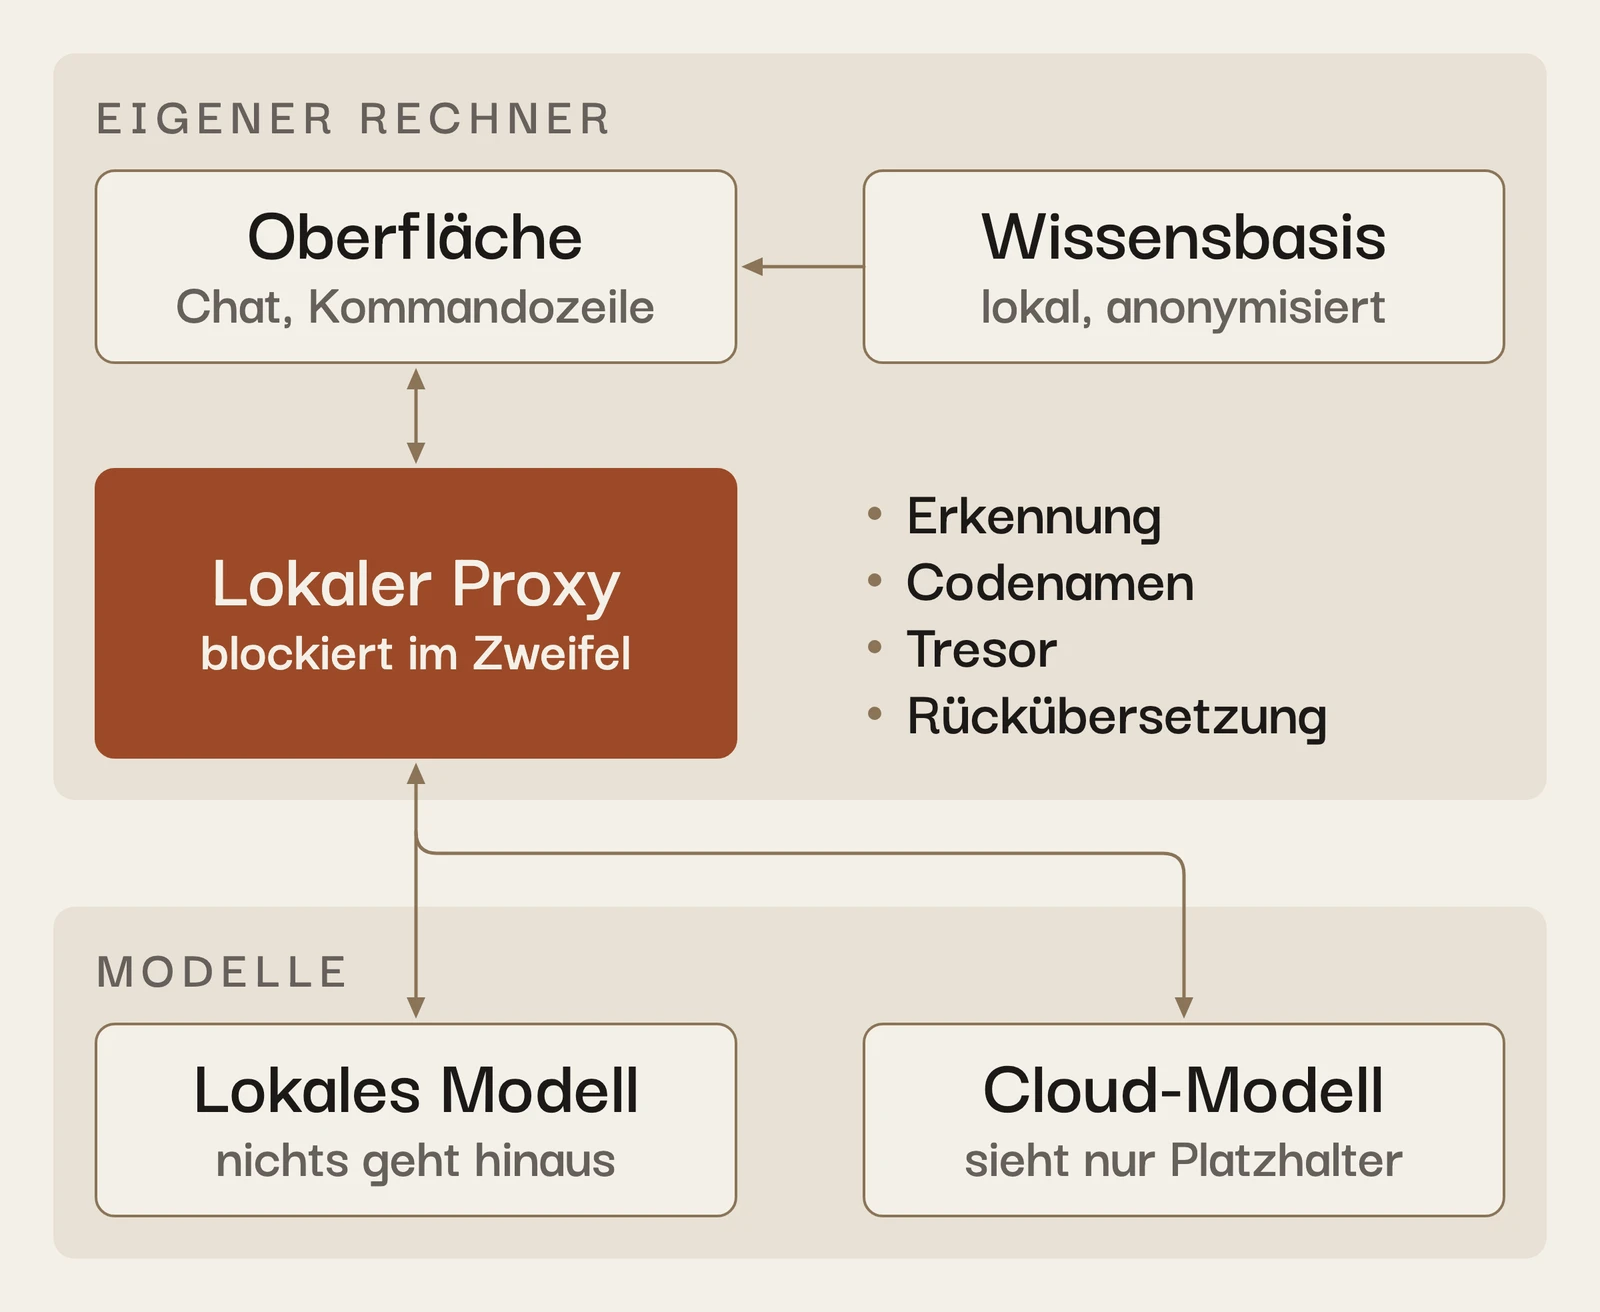
Der Proxy sitzt zwischen Oberfläche und Sprachmodell. Alles außer dem Modell selbst läuft auf dem Rechner der Nutzerin oder des Nutzers.
- Oberfläche und Kommandozeile: ein Chat im Browser auf dem eigenen Rechner, gebaut mit Preact, und die Kommandozeile
aai chat. - Lokaler Proxy: ein Python-Dienst auf Basis von Starlette, der jede Anfrage durch die Anonymisierung schickt.
- Erkennung: GLiNER als primäres Modell mit 24 Kategorien, spaCy als Rückfallebene, Microsoft Presidio und eigene Erkenner für österreichische Titel, Bildungseinrichtungen, Behörden und Adressen.
- Codename-Engine: ersetzt jede Fundstelle durch einen semantischen Platzhalter in eckigen Klammern. Das Modell weiß so, dass an dieser Stelle eine Person oder ein Ort steht, kennt aber den echten Namen nicht.
- Verschlüsselter Tresor: speichert die Zuordnung von Platzhalter zu Original lokal, verschlüsselt mit Fernet, in vier Schutzstufen mit eigenen Ablaufzeiten.
- Wissensbasis: eine lokale SQLite-Datenbank. Dokumente werden vor der Indexierung anonymisiert.
- Sprachmodell nach Wahl: Anthropic, OpenAI, Mistral oder Google mit eigenem Schlüssel, lokal über Ollama oder LM Studio.
- Rückübersetzung: setzt die Originaldaten lokal wieder in die Antwort ein.
Umsetzung
Die wichtigste Regel heißt fail-closed. Scheitert die Anonymisierung, blockiert der Proxy die Anfrage mit einer Fehlermeldung. Ein ungeschützter Text geht nie als Notlösung hinaus.
Anonymisiert wird nicht nur die neue Nachricht, sondern vor jedem Senden der ganze Gesprächsverlauf. Antworten des Modells enthalten schon Platzhalter und sind entsprechend markiert; so bleiben die Codenamen über das ganze Gespräch stabil. Personenbezogene Daten landen in keinem Protokoll.
Eine Funktion wurde bewusst wieder entfernt: die automatische Wahl des Modells. Sie war eine Black Box und widersprach dem Grundsatz, dass Nutzer die Kontrolle behalten. Ersetzt haben sie drei Werkzeuge, die man bewusst einschaltet:
- Slash-Befehle am Anfang einer Eingabe.
- Skills als Markdown-Dateien mit empfohlenem Modell; die eigene Wahl im Kopf des Chats hat Vorrang.
- Eine Wissensbasis, deren Textausschnitte man vor dem Senden sieht und auswählt.
Power-User-Funktionen sind standardmäßig aus. Cloud-Synchronisation und Marktplatz gibt es bewusst nicht. Ein früheres Problem ist gelöst: Manche Modelle passten Platzhalter grammatikalisch an oder übersetzten sie mit, sodass die Rückübersetzung sie nicht mehr fand. Auch solche veränderten Platzhalter werden heute wieder den echten Daten zugeordnet.
Infrastruktur und EU-Konformität
AUSTR.AI hat zwei getrennte Bereiche. Die Website austr.ai zeigt in einer Demo, was der Proxy kann; nur diese Demo läuft auf einem Server und nutzt dafür ein Modell von Mistral. Das Werkzeug selbst läuft vollständig beim Nutzer. Es schickt keine Nutzerdaten an einen Server von AUSTR.AI.
Die einzige Verbindung nach außen geht an den Modellanbieter, den die Nutzerin oder der Nutzer gewählt hat, mit eigenem Schlüssel und mit bereits anonymisiertem Text. Wer ein lokales Modell über Ollama oder LM Studio nutzt, schickt gar nichts hinaus. Ausnahme sind Cloud-Modelle, die Ollama inzwischen ebenfalls anbietet: Sie laufen beim Anbieter, auch wenn man sie über Ollama anspricht. Beim ersten Start lädt das Werkzeug einmalig die Erkennungsmodelle herunter; dabei fließen keine Nutzerdaten.
Rechtlich ist das eine Pseudonymisierung im Sinn von Artikel 4 Nummer 5 DSGVO: Der Schlüssel zur Zuordnung liegt im lokalen Tresor, der Modellanbieter sieht nur Platzhalter. Keine automatische Erkennung findet jeden Hinweis auf eine Person. Umschreibungen wie „der neue Leiter der Rechtsabteilung“ bleiben ein Restrisiko, das Nutzer kennen müssen. Fail-closed und lokale Modelle für die heikelsten Texte halten es klein.
Ergebnis und Wertrechnung
Der PrivacyProxy macht Cloud-Sprachmodelle für Texte mit personenbezogenen Daten nutzbar, ohne dass diese Daten das Gerät im Klartext verlassen. Für die heikelsten Texte bleibt der Weg über ein lokales Modell, ohne jede Verbindung nach außen.
Der Nutzen lässt sich in drei Posten rechnen:
- Zeitersparnis = Texte pro Woche, die bisher von Hand geschwärzt wurden, × Minuten je Text × interner Stundensatz.
- Neu erschlossener Nutzen = Aufgaben pro Woche, die ohne Anonymisierung gar nicht an ein Cloud-Modell dürften, × Zeitgewinn je Aufgabe durch das Modell × interner Stundensatz.
- Kosten = Modellnutzung beim gewählten Anbieter + Einrichtung und Pflege der lokalen Installation.
Der zweite Posten wird leicht übersehen: Er erfasst Aufgaben mit sensiblen Texten, für die ein Cloud-Modell ohne Anonymisierung nicht in Frage kommt. Ein vermiedener Datenschutzvorfall lässt sich nicht seriös in Geld rechnen. Er gehört trotzdem in die Entscheidung, als eigene Zeile ohne Betrag.
Weitere Projekte finden Sie in der Übersicht der Referenzprojekte.